大家好,我是 Lucifer。今天聊一个做量化的人天天要面对的问题:回测报告里的夏普比率,到底是本事,还是运气。
你大概率经历过这个瞬间:Freqtrade 回测跑完,终端哗啦啦吐出一堆指标——总收益、夏普比率、索提诺比率、卡玛比率、最大回撤……大多数人只盯着收益率那一行,眼睛发直,手已经悬在”实盘启动”按钮上了。稍微冷静一点的会瞟一眼 Sharpe 1.8,然后开始灵魂拷问:1.8,算”策略很强”,还是算”我菜到看不懂”?
《小菜的交易系统》里说过,一套交易系统必须”可量化”——进场理由要量化、出场条件要量化,绩效同样要量化。量化绩效量化的是什么?不只是”赚了多少”,而是每一份收益背后,你扛了多少惊吓。这套体系叫风险调整后收益指标,本文用纯标准库 Python(random / statistics / math)把它们挨个算一遍,所有代码和数字都是真实运行的。最后回答那个终极问题:你的夏普,是本事,还是猴子掷飞镖。
一、单看收益率,等于裸奔
先做个选择题,两个策略摆你面前,你选哪个?
- 策略 A:年化 100%,最大回撤 80%
- 策略 B:年化 30%,最大回撤 8%
只看收益率,A 吊打 B,没悬念。但把”风险”放进来看,画风就变了:
- 策略 A 亏 80% 之后,要涨 400% 才能回本。100 万进去,最低点剩 20 万——绝大多数人在 -50% 的位置就已经心态爆炸割肉离场,根本活不到”回本那天”。年化 100% 的前提,是你先扛住一段水下 80% 的岁月,像一份年薪百万、但每年要先赌一次命的工作。
- 策略 B 回撤 8%,亏损期你该吃吃该睡睡——8% 就是这个策略的”正常呼吸幅度”,像坐公交,颠两下是路况,不是车祸。
画个重点:收益率回答的是”赚多快”,回撤和波动回答的是”路上有多颠”。把两者合起来看的指标,叫风险调整后收益:每承担一单位风险,换来多少收益。下面从最有名的那个开始。
二、夏普比率:每受一份惊吓,换多少钱
夏普比率由 William Sharpe 提出(1990 年诺贝尔经济学奖),定义长这样:
1 | Sharpe = (Rp − Rf) / σp |
看着吓人,翻译成大白话就一句:每受一份惊吓,换多少钱。挨个拆:
- 分子 Rp − Rf:你比”躺赢”多赚的部分。Rf 是无风险利率——钱放在完全不冒险的地方也能躺赚的那点利息。夏普只认冒险换来的钱,躺赚的不算本事,所以要先减掉。
- 分母 σp:收益的标准差,也就是波动率——净值每天上蹿下跳的幅度。翻译过来就是”惊吓剂量”。
你可能在想:赚 30% 不就行了,管它路上怎么颠?还真不行。看下面两条曲线——终点一样,一年都赚 65%,但策略 A 全程坐过山车,半道还挖了个 -15% 的坑,你大概率在坑里割肉离场,根本领不到终点的奖金;策略 B 匀速爬坡,你睡得着觉。
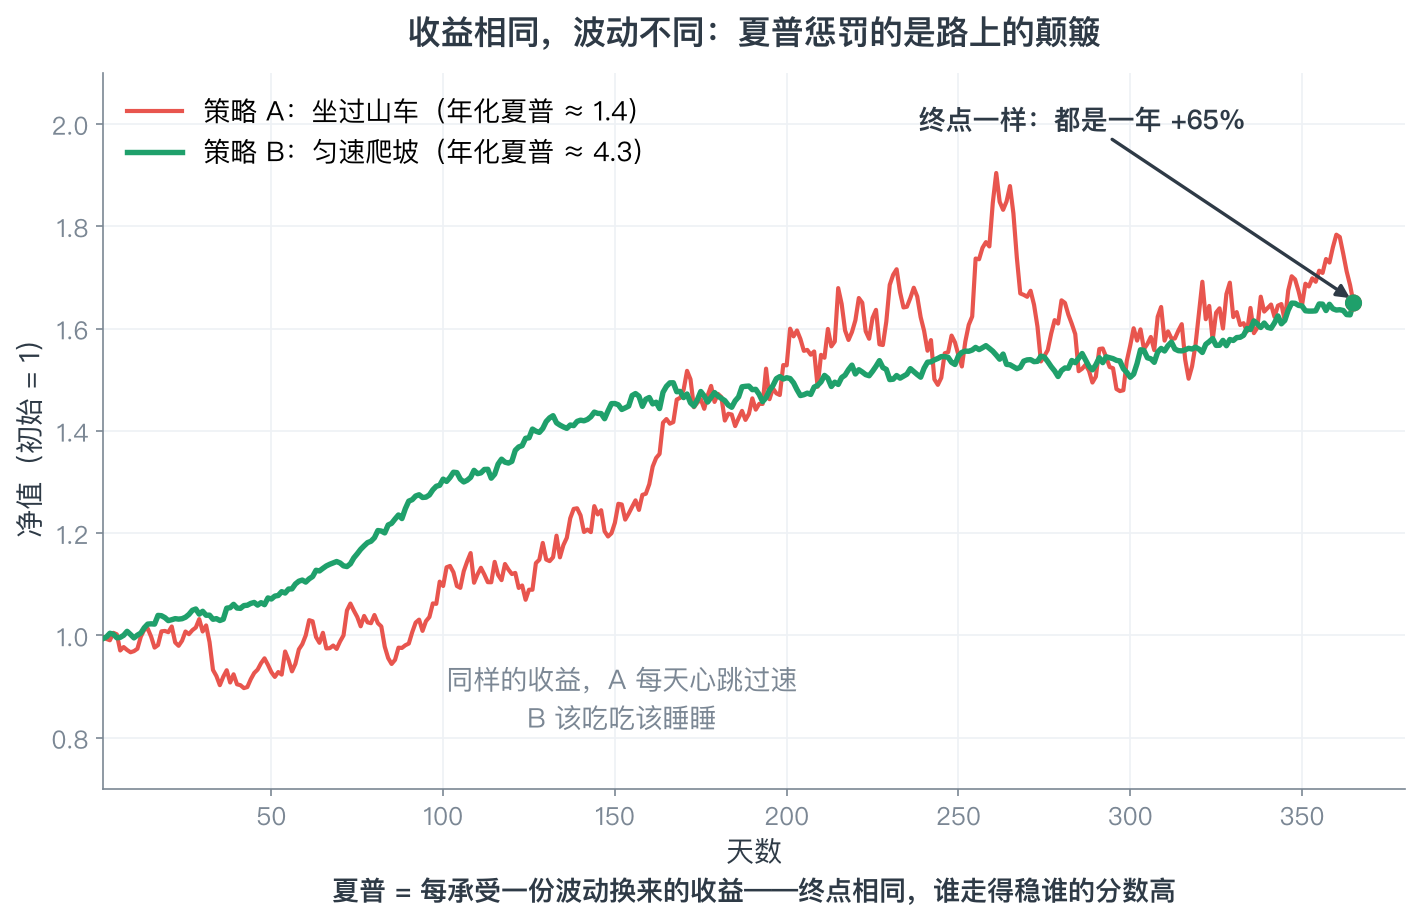
画个重点:夏普惩罚的正是这种颠簸——终点相同,谁走得稳谁的分数高。同样年赚 30%,一个策略让你天天心跳过速,一个策略让你睡到自然醒,后者的夏普高得多:钱一样多,每份惊吓换到的钱不一样,含金量就不一样。
无风险利率取多少?
教科书答案是美国 3 个月期国债收益率——“无风险”的锚就是政府短期信用,全球机构默认用它。加密圈的常见做法是直接简化为 0:一是比较两个策略的相对优劣时,Rf 对所有策略同减一个常数,排序基本不变;二是少一个要交代的参数,代码更干净。代价是所有策略的夏普都被整体抬高了一点,所以跨市场、跨文章比较夏普时,先确认口径一致。本文所有计算取 Rf = 0。
为什么要乘 √365 或 √252?
直接用日收益算出来的夏普,量纲是”每天的性价比”,没法和年化收益对话,所以要年化。年化系数 √N 的出处是概率论,不是玄学。直觉版是这样的:
先记住一个常识:时间拉得越长,波动反而越”平”。抛 10 次硬币,正面比例可能是 30% 这种离谱数字;抛一万次,比例几乎贴着 50%——一次一次的随机,在长过程中互相抵消了。日收益也一样:365 天的总波动,不是日波动的 365 倍,而是 √365 倍(方差才相加,开根号之后就缩了)。
麻烦在这儿:波动会互相抵消,收益不会。赚就是赚,365 天的总收益是日均值的实打实 365 倍。于是:
- 收益端:日均值 × 365(线性放大);
- 风险端:日波动 × √365(只放大了 √365 倍)。
两边一除,年化夏普 = (μ/σ) × √N。√N 就是补上”风险端没跟着收益端一起线性放大”的那笔账——不做这个补偿,周期越长的夏普显得越低,纯属记账错误,不是策略变差了。
N 取多少,看你的市场一年有几根日 K 线:
- 加密市场 7×24 全年无休:N = 365,√365 ≈ 19.10;
- 美股一年约 252 个交易日(52 周 × 5 天 = 260,扣除法定假日):N = 252,√252 ≈ 15.87。
拿股票的 √252 去年化加密策略,所有夏普都会被系统性压低约 17%——一个低级但极常见的错误,回去检查一下你手里的回测框架。
经验标尺(以及两个警惕)
| 年化夏普 | 评价 |
|---|---|
| < 0.5 | 弱:这个收益波动比,不如定投指数省心 |
| 0.5 ~ 1 | 一般:有点东西,但不够付你的盯盘时间 |
| 1 ~ 2 | 良好:专业机构的主战场,多数 CTA 和趋势策略落在这里 |
| > 2 | 优秀:先别激动,看下面两个警惕 |
警惕一:高频/做市策略的夏普天然高。日均成交几千次,单次风险被海量交易摊平,顶级做市商夏普 10+ 不稀奇。拿日线策略的 1.5 去跟人家的 8 比,是拿马拉松成绩去对比百米冠军的配速——类别不同,不可直接对表。
警惕二:样本短的夏普不可信。这是本文真正想说的重点,先埋个伏笔,第七节放 1000 只猴子出来捅破它。
顺便一提,Freqtrade hyperopt 里的 SharpeHyperOptLoss 损失函数,就是在直接优化本文讲的这个数字——hyperopt 的玩法见《多信号评分策略实战》,优化目标选得好不好,直接决定你调出来的是策略还是过拟合怪兽。
三、夏普的兄弟们:Sortino、最大回撤、Calmar
夏普有个先天槽点:分母 σp 把上涨也算成”惊吓”。账户暴涨 20% 对你来说不是惊吓,是惊喜——顶多让你下个月的消费预算开始膨胀。于是有了修正版。
Sortino(索提诺比率):把分母换成下行波动——只统计亏损日的颠簸,盈利日记 0,再同样年化。它只惩罚”你不想要的波动”,保守派专用。
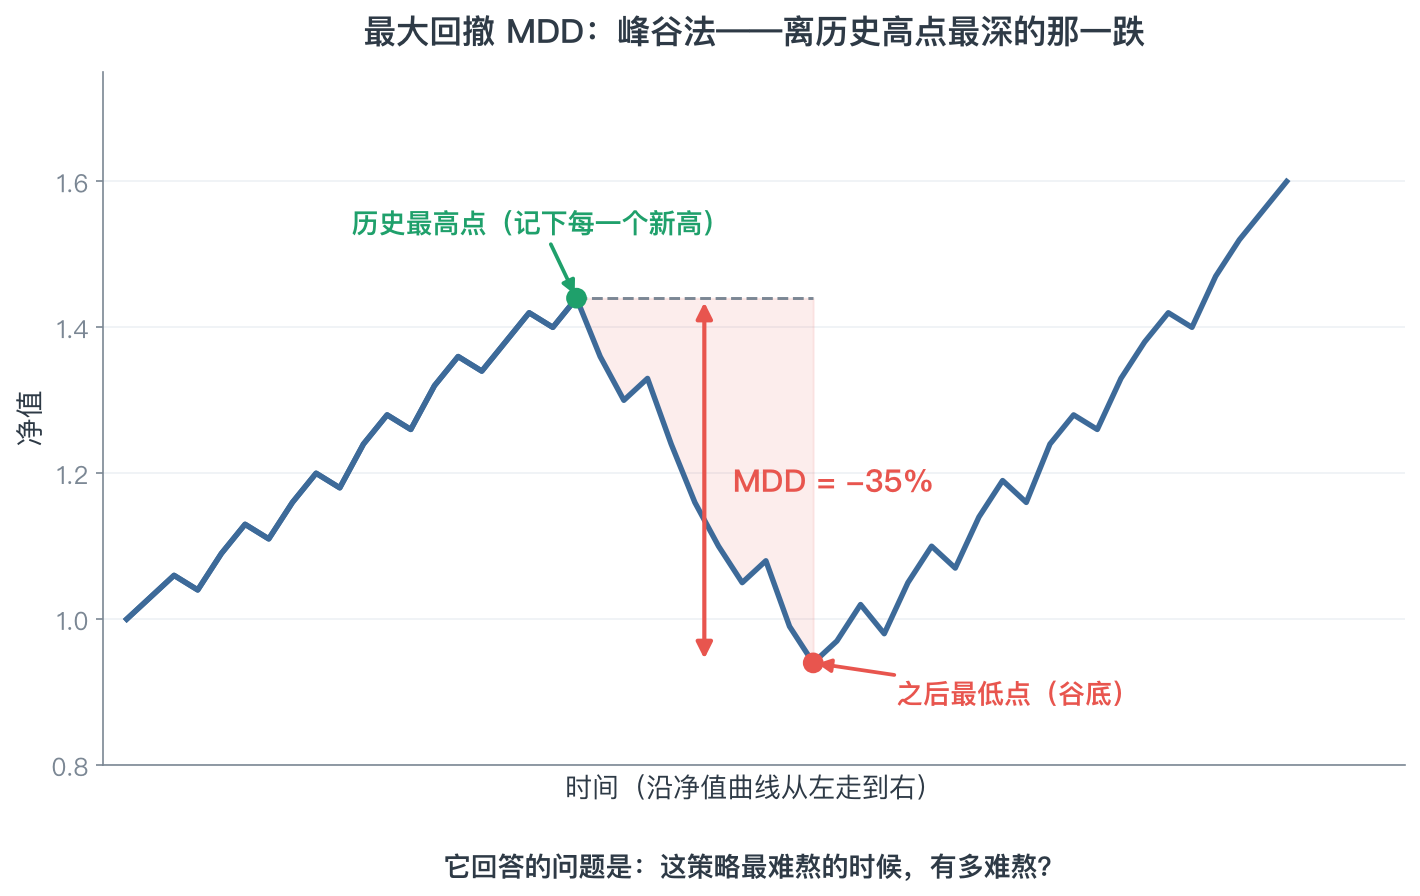
最大回撤 MDD(Maximum Drawdown):峰谷法——沿净值曲线从左走到右,每创一个历史新高就记下来,然后看净值离这个高点最深跌到哪,取历史最惨的一次。它不是比率,是一个百分比:-34% 就是最惨那一刻你的账面浮亏。回答的问题是:”这策略最难熬的时候,有多难熬?”
Calmar(卡玛比率):年化收益 / |MDD|,回撤视角的性价比——收益除以你挨过的最重那一拳。
四个指标各看一面,谁也替代不了谁:
| 指标 | 一句话公式 | 惩罚什么 | 适合回答的问题 | 盲区 | ||
|---|---|---|---|---|---|---|
| 夏普 | (收益−无风险) / 总波动 | 全部波动(含上涨) | 整体性价比 | 把暴涨也当风险 | ||
| Sortino | 收益 / 下行波动 | 只算下跌 | 我只在乎亏 | 下跌样本少,估计不稳 | ||
| MDD | 峰到谷的最大跌幅 | 最惨的一跌 | 极端时刻能否扛住 | 只记最差一次,不管频率 | ||
| Calmar | 年化收益 / \ | MDD\ | 最惨的一跌 | 回撤性价比 | 分母只有一次事件,极不稳定 |
注意最后一列:每个指标都有盲区。Freqtrade 的回测报告把这一家四口全打出来,就是让你对着看,而不是只截其中一张发朋友圈——报告在哪看,见《Freqtrade 量化风暴》。
四、手搓一个指标计算器
光说不练假把式。下面用纯标准库把五个数一次算齐:输入一段模拟日收益序列(365 天,日均值 0.15%,日标准差 1.5%——典型”加密风格”参数),输出全套指标。看代码前先给直觉:净值曲线就是每天 (1+r) 连乘;夏普和 Sortino 都在算”均值除以某种波动”,差别只在波动怎么定义;MDD 用峰谷法一遍扫出来。
1 | import math |
运行结果(真实输出):
1 | 样本天数 : 365 |
三个细节值得圈出来:
- 夏普 3.45 明显虚高。按塞进去的真实参数算,理论夏普 = (0.15% / 1.5%) × √365 ≈ 1.91,但这一年的样本均值恰好走了运,算出来 3.45。看清楚:样本噪音不需要任何人造假,就能把数字抬高 80%——这还只是抽样抽歪了,没有任何人捣鬼。
- Calmar 12.94 离谱。年化波动 28.9% 的资产,最大回撤只有 -12.34%?纯粹是这段样本恰好没赶上深回撤——像体检那天恰好没发烧,不代表身体好。Calmar 的分母是”最惨的一跌”这单独一个事件,天然比夏普不稳,一年样本的 Calmar 参考价值有限。
- 累计收益 = 年化收益,是因为样本恰好 365 天(n 等于年化期数)。如果你只回测了半年,几何年化会把数字按复利放大——所以看任何报告先看样本长度,再看数字。
顺带说:这段模拟序列的真实参数确实有 edge(日均值 0.15% > 0,是我们亲手塞的),所以 3.45 虽虚高,方向没错。真正瘆人的问题是:一个零 edge 的策略,光靠运气能把夏普飘到多高?第七节,放猴子出来。
五、胜率、盈亏比与期望值:一笔摆摊的账
夏普家族看的是日收益序列;还有一组指标看”每一笔交易”:胜率、盈亏比、期望值。先统一单位——本文用 R 计价,1R = 你单笔愿意亏掉的风险额(比如本金的 1%)。亏 1R = 打到止损;赚 1.5R = 盈利是风险额的 1.5 倍。
每笔交易的期望值:
1 | 期望 = 胜率 × 平均盈利 − 败率 × 平均亏损 |
别急着背公式,这笔账摆摊的人天天在算。你摆摊进货,一批货压 100 块(就是 1R),进了 10 批:
- 成 5.5 批,每批赚 150 块(盈亏比 1.5)——赚回 825 块;
- 砸 4.5 批,每批赔 100 块——赔掉 450 块。
10 批净赚 375 块,平均每批 +37.5 块,折算回来就是期望 +0.375 R/笔。你错将近一半的次数照样赚钱,原因只有一条:赢单比亏单大。摊贩不会因为砸了两批货就收摊,只要每一批的账算下来是正的,重复进货就是印钱。
用这本账看两种熟悉的面孔:
- 扛单党:胜率 95%,平均赚 0.1R(赚点小钱就跑),偶尔一次扛到爆亏 3R。摆摊版:每批赚 10 块,天天开张、眉开眼笑;偶尔一批砸手里,赔 300。期望 = 0.95 × 0.1 − 0.05 × 3 = -0.055 R/笔。天天都在赚,数学上在给市场免费打工——摊位看着红火,年底一算账,倒贴房租。不加止损的网格、逆势加仓的抄底党,很多都是这个画像。
- 趋势党:胜率 55%,平均赚 1.5R,平均亏 1R。就是上面那个摊子:十批货错四批半,照样稳稳赚钱。
记住 55% 和 1.5 这两个数字,马上还要出场。
《加密交易的风险管理》里讲过 Kelly 公式:f = (bp − q) / b,最优仓位由胜率 p 和赔率 b 决定。那篇文章留下的悬念是:”胜率 55%、赔率 1.5”这些输入从哪来?答案现在揭晓:*不是拍脑袋,是从你自己的交易记录里统计出来的。下一节实操——顺便看看,统计出来的数能歪到什么程度。
六、从交易记录统计:凯利公式的进料口
模拟一个真实参数已知的策略(真实胜率 55%、真实盈亏比 1.5,每笔金额带 ±30% 随机波动),让它打 100 笔交易。然后假装我们不知道真相,只看交易记录做统计——你回测的时候,能看到的也只有交易记录。
1 | import math |
运行结果(真实输出):
1 | 交易笔数 : 100 |
看懂这份输出,比看懂任何营销海报都重要:
- 统计胜率 63%,真实只有 55%——差 8 个点,但这完全在正常范围内:100 笔样本的胜率标准误约 ±5%,63% 也就是偏离 1.6 个标准误而已。同一个策略重复统计 20 次,胜率在 49%~62% 之间飘。你以为的”状态好坏”,很多时候只是抽样噪音——同一锅汤舀一勺尝咸淡,这一勺的咸淡不代表整锅。
- 凯利公式对输入误差极其敏感。真实参数下的凯利是 25%,但统计胜率被高估到 63% 后,凯利直接膨胀到 37%——胜率高估 8 个点,建议仓位多吃近一半。这就是风险管理那篇强调”实盘用半凯利甚至四分之一凯利”的数学原因:不是怂,是在对冲统计误差。
- 单笔固定风险 1%,只相当于这份凯利建议的 3%,保守得近乎无聊。但复利的本质是活着,无聊地活着比刺激地死去强。
实操结论:统计值围绕真实值波动,样本越大越接近真相。100 笔起步,300 笔像样;至于 30 笔交易统计出的”胜率 70%”——30 笔的标准误约 ±9%,运气好统计出 70%、运气差就能统计出 40%,全看抽到哪一手——建议直接当段子听。
七、运气还是技巧:1000 只猴子的审判
前面所有铺垫,都是为了回答开场那个问题。思路粗暴而优雅:造 1000 个”零期望”的纯随机策略——每天从均值为 0 的正态分布里抽一个收益率,没有任何 edge,纯抛硬币。你可以把它们想象成 1000 只猴子掷飞镖。然后挨个算年化夏普,看猴群整体能考出什么成绩——尤其是最好的那只猴子,能好到什么程度。
1 | import math |
运行结果(真实输出):
1 | --- 样本 365 天:1000 个零期望随机策略的年化夏普 --- |
把结果翻译成人话:
- 365 天样本:1000 只猴子,夏普中位数约 0(意料之中,它们本来啥也不是),但 95 分位高达 1.647,最强的那只干到 3.125。也就是说,纯靠运气的”策略”,有 5% 的概率考出 1.65 以上,3.9% 的概率考出 1.8 以上。
- 30 天样本:95 分位飙到 5.726,最大值 11.8,30.4% 的猴子夏普超过 1.8。”我这个策略跑了俩月,夏普 5”——统计学上这句话的信息量约等于”我今天出门穿了袜子”。
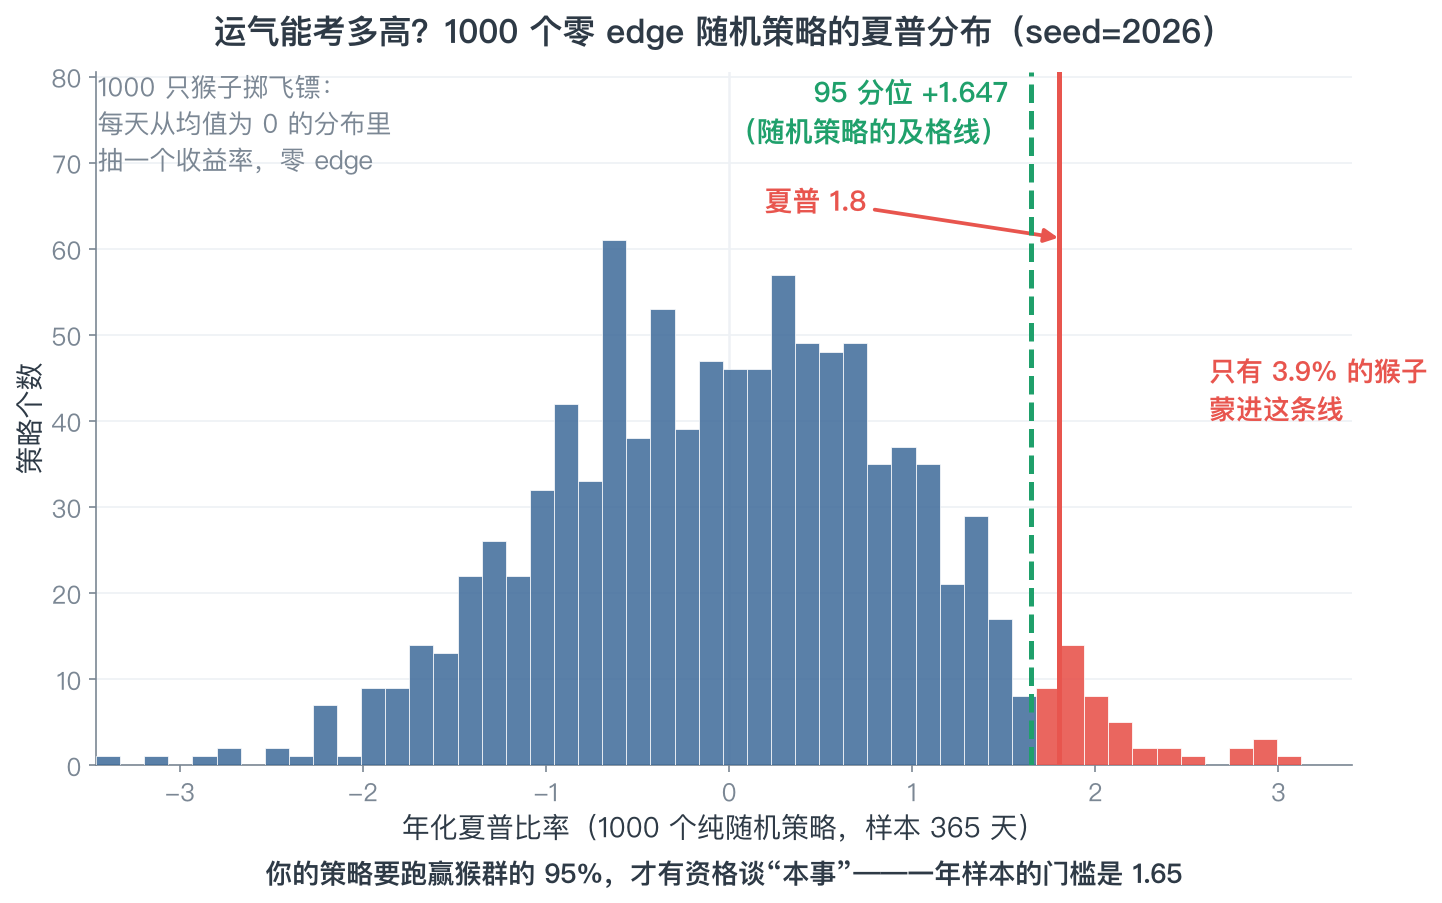
看图更直白:蓝色柱子是猴群的常态成绩,右边那条红色小尾巴,就是纯运气能摸到的高度。你的策略得跑赢猴群的 95%,才轮得到谈”本事”。
这也不是巧合,是统计学亲手送的记忆点:当样本是 365 天时,年化夏普 = (μ/σ) × √365,数值上恰好就是检验”均值是否为零”的 t 统计量(t = μ / (σ/√365))。而 t 分布的单侧 5% 临界值是 1.645——蒙特卡洛实测 95 分位 1.647,严丝合缝。30 天样本同理:1.70 × √(365/30) ≈ 5.9,和实测的 5.726 也对上了。
于是判定标准出炉:
你的策略夏普,必须显著压过同样本量的随机 95 分位,才配讨论”是不是真有东西”。
跑满一年:夏普 > 1.65 才刚过及格线——纯随机只有约 4% 的概率伪装到这个水平;
只跑 30 天:随机策略三成都能上 1.8,你的夏普等于没测。
回收开场的伏笔。夏普 1.8,如果是 365 天样本跑出来的:刚过 1.65 的显著性线,可以说”可能有真东西”,但优势不大,且仍有约 4% 的概率它纯属运气;如果是 30 天样本跑出来的:请回炉重造。第四节那个夏普 3.45 的模拟策略,已经超过了 1000 只猴子的最大值 3.125——它确实有 edge(毕竟是我们亲手塞进去的)。关键在于:如果你不做这场审判,报告里的 3.45 和运气冒充者的 3.13,长得一模一样。
八、防过拟合:模拟考的高分不算数
最后泼一盆必要的冷水。本文算的所有指标都是”样本内成绩”,相当于模拟考——而模拟考是可以作弊的:参数扫描扫到夏普 3.8、未来函数偷看明天的收盘价、用全市场历史筛出”恰好躲过每次大跌”的规则——回测曲线上是天使,实盘上是祭品。真正算数的是样本外:模拟盘,或者干脆实盘小仓。前视偏差、幸存者偏差、参数过拟合,每一个都值得单独写一篇(已列入写作清单)。今天只需要记住一条铁律:回测指标的唯一用途是生成假设,验证必须靠样本外。夏普压过了 1.65,而且是样本外算出来的,才轮到你兴奋。
总结
- 单看收益率等于裸奔,风险调整后收益才是策略的真实成绩单:同样赚 30%,睡得着觉的那个含金量更高。
- 夏普 = (Rp − Rf) / σp,翻译过来是”每受一份惊吓,换多少钱”。无风险利率教科书取美债收益率,加密圈常简化为 0;年化系数来自 √N——加密 365 天、美股 252 天,别拿错。
- 标尺:<0.5 弱,0.5~1 一般,1~2 良好,>2 优秀但要警惕——高频策略夏普天然高,短样本夏普天然不可信。
- Sortino 只罚下跌,MDD 记录最惨一跌,Calmar 看回撤性价比;每个指标都有盲区,要对着看。
- 期望 = 胜率 × 平均盈利 − 败率 × 平均亏损,就是摆摊的账:赢单比亏单大,错一半照样赚;凯利公式的胜率和赔率从交易记录统计而来,而 100 笔的统计误差就足以把建议仓位吹大近一半。
- 蒙特卡洛审判线:一年样本的夏普要压过 1.65(恰好是 t 检验 5% 显著水平的随机上界),30 天样本的夏普约等于抛硬币的录音回放。
- 以上一切,只在样本外可信——模拟考的高分不算数。
相关阅读
- 《Freqtrade 量化风暴》:回测输出的指标在哪看
- 《多信号评分策略实战》:hyperopt 的 SharpeHyperOptLoss 就是在优化本文的夏普
- 《加密交易的风险管理》:Kelly 公式的胜率与赔率输入,本文教你怎么从交易记录里算出来
- 《小菜的交易系统》:”可量化”的落点就是这套指标