在 《Web3 的入口 - 区块链钱包》 的结尾,我立过一个 flag:钱包开发的细节还没讲,留言多就专门写一篇。一年半过去了,留言不算多,但这个债我一直记着——毕竟在 web3 圈子混,欠的债是要还的,我只是不想用私钥签名赖账。
那篇文章留了三个没讲清楚的尾巴:私钥到底从哪来?助记词怎么就变成了一串钥匙?地址又是怎么从公钥变出来的?而且为了教学方便,旧文的示例里把公钥直接当地址用(就是 get_address() 里返回的那串 hex),真实的推导根本不是这么回事,本文就来补上这一课。
先把全程的路线图亮出来,你可以把它当成一次”寻根之旅”:一串随机数从出生(熵),到翻译成人话(助记词),磨成始祖(种子),繁衍出一族后代(私钥),最后领到能晒出来的门牌号(地址)。这条链是:
熵 → 助记词 → 种子 → 派生路径 → 私钥 → 公钥 → 地址
只有走完这条线,你才能真正理解那句听起来很魔法的话——“同一套助记词能同时管理以太坊、比特币、Solana 上无数个钱包”。这不是魔法,是三份 BIP 规范(BIP39、BIP32、BIP44)叠出来的组合技。本文全程代码驱动,每一段代码都是我真实跑过的,老规矩,建议你跟着敲一遍。
私钥:就是一个数字,别怕
先来祛魅。私钥听起来神秘兮兮的,说白了:它就是一个 256 位的随机数,没有任何格式上的魔法。
打个比方。如果区块链是一家银行,私钥就是你保险柜的密码。这个保险柜有个特点:不认人,只认密码——谁能一字不差报出密码,谁就是主人。所以圈子里那句名言”not your keys, not your coins”,翻译过来就是:密码不在你手里,保险柜就不算你的。
硬要说约束的话,是这个数必须落在 1 到 n-1 之间,n 是 secp256k1 椭圆曲线的阶(一个略小于 2^256 的素数)。也就是说,你的私钥只是从约 2^256 个数字里挑出来的一个。
“随机”很重要。你要是拿自己的生日、手机号来当私钥,那黑客都不用破解密码学,试一圈生日就能把你的资产收走——等于把保险柜密码设成了 123456。所以正经钱包都用密码学安全的随机源(os.urandom、硬件真随机数)来生成。
你可能要问了:那我不停地猜数字,总能撞上别人的私钥吧?先别急,我们算一笔账。2^256 ≈ 1.16 × 10^77,而可观测宇宙的原子总数大约是 10^80 量级。换句话说,把宇宙里每个原子都变成一台超级计算机、从宇宙诞生猜到宇宙热寂,撞中某个特定私钥的概率依然约等于零。所以与其琢磨猜别人的私钥,不如想想怎么别把自己手里的弄丢——历史上丢币的案例,99% 是人祸而不是密码学被攻破。
公钥:拿私钥在”公共模具”上压一个点
有了私钥 k,公钥是通过椭圆曲线上的”乘法”算出来的:
1 | 公钥 P = k × G |
这里 G 是 secp256k1 曲线上一个固定的基点。它不是秘密,全世界的钱包用的都是同一个 G——你可以把它理解成一台印钞机的公共模具:模具人人可见,但往模具里放什么”料”(私钥),决定压出来的是什么(公钥)。
曲线方程和域运算本文不展开(想啃数学的可以去读标准文档),只需要建立一个直觉:
- 正推容易:知道 k 和 G,算 P 只是一堆固定规则的加法,毫秒级完成。像把苹果榨成汁,咔咔几下就好。
- 反推不可行:知道 P 和 G,想反推出 k?这就是著名的”椭圆曲线离散对数问题”,目前没有多项式时间的算法。想把果汁还原成苹果,做不到。
这就是非对称加密的基石:公钥可以随便给人看,私钥死也不能丢。用 Python 的 ecdsa 库演示一下(pip install ecdsa):
1 | import os |
真实运行输出:
1 | 曲线阶 n = 0xfffffffffffffffffffffffffffffffebaaedce6af48a03bbfd25e8cd0364141 |
(私钥是随机生成的,你跑出来会是另一对私钥公钥,曲线阶 n 则永远是这个值——它是全宇宙通用的”模具参数”。)
看输出:私钥是一个大整数;公钥是 128 个 hex 字符。注意,公钥是 64 字节:曲线点的 X 坐标 32 字节 + Y 坐标 32 字节,这叫非压缩公钥——公钥本质上是曲线上的一个点,有横坐标和纵坐标。如果在前面再拼一个 04 前缀,就是完整的 65 字节非压缩格式(04 || X || Y)。记住这个结构,算地址的时候会用到。
BIP39:把一串 0/1 翻译成人话
先抛个问题:一个 256 位的私钥,用 hex 写出来是 64 个字符。让人手抄 64 个十六进制字符,抄错一个字符资产就没了——这跟让人背圆周率没什么区别,反人类。
BIP39 的思路很朴素:人不擅长背符号,但擅长背词。 所以它准备了一本 2048 个单词的”密码本”,专门把 0/1 串翻译成人话。
完整流程是这样的:
- 掷骰子:生成 128 位熵(16 字节随机数)。这 128 下骰子的结果,就是你整个钱包宇宙的”奇点”;
- 算自检位:对熵做 SHA256,取哈希结果的前 4 位作为校验和。玩过身份证的都知道,身份证号最后一位就是校验码,专门防抄错——助记词这里是同款思路;
- 拼起来:熵(128 bit)+ 校验和(4 bit)拼成 132 bit;
- 切段:切成 12 段,每段 11 bit;
- 查密码本:每段 11 bit 是一个 0~2047 的数字,当页码去查那本 2048 个单词的标准词表,翻出 12 个单词。
反过来(导入助记词恢复钱包)也一样:12 个词查回 12 个页码,拼回 132 bit,重新算一遍 SHA256 验证校验和,再取出熵。自检位的意义就在这:你抄错一个词,拼出来的 bit 序列大概率过不了校验,钱包直接报错,而不是默默给你恢复出一个空钱包。
最后一步,把助记词磨成种子。这一步用的是 PBKDF2——一种故意设计得很慢的密钥推导函数。为什么故意慢?你想想有些 App,密码连错几次就让你干等 30 秒,就是在拖暴力破解的后腿。PBKDF2 同理:攻击者每试一个助记词,都得老老实实跑完 2048 轮哈希,成本直接翻 2048 倍。
1 | import hashlib |
输入是助记词(当密码)和 mnemonic + passphrase(当盐),磨 2048 轮,产出 512 位的种子。这个 passphrase 是可选项,江湖人称”第 25 个词”——同一个助记词配不同 passphrase,磨出来的种子完全不同。相当于 12 个词是”卡”,passphrase 是”密码”:光捡到卡,刷不开门。
下文动手环节里,为了能在文章里把整个流程跑完看得清清楚楚,我用了一张只有 16 个词的 mini 词表演示(索引从 11 bit 缩到 4 bit)。这是纯粹的教学简化,真实的 BIP39 词表是 2048 个词 × 11 bit 索引,流程一模一样,只是规模不同。千万别拿 mini 词表生成”助记词”去管理资产。
BIP32/BIP44:一个祖先,繁衍出一棵家谱树
现在的链这么多,每种代币又要管理一堆地址。如果每生成一个新地址就要重新备份一次私钥,那备份能打到怀疑人生。
BIP32 提出的方案叫 HD 钱包(Hierarchical Deterministic,分层确定性)。名字唬人,意思很家常:一个祖先,繁衍出一棵家谱树。 种子是始祖,往下儿子生孙子、孙子生曾孙,子又生孙,孙又生子。每个成员在家谱上的位置由”路径”唯一确定——路径唯一,这个人就唯一。”确定性”说的就是这事儿:同样的种子,长出来的树一模一样;同样的路径,走到的人一模一样。你没有必要保存每个后代,只要记住始祖,族谱上的人随用随取。
CKD:孩子是怎么生出来的
从父密钥推子密钥的过程叫 CKD(Child Key Derivation)。听着玄,核心就一次 HMAC-SHA512:
1 | I = HMAC-SHA512(key = 父 chain code, data = 父密钥 || 索引(4字节)) |
输出 64 字节,劈成两半:
- 左 256 bit(IL):子私钥的”偏移量”,参与计算
子私钥 = (IL + 父私钥) mod n; - 右 256 bit(IR):子 chain code,传给子辈接着往下生。
chain code 是什么?你可以把它理解成这一房人的”基因”。生一次娃,基因就换一版,所以同一索引在不同层级派生出的结果完全不同——大房的老三和三房的老三,压根不是一个人。
hardened 派生 vs 普通派生:上没上锁的门
派生路径里的撇号(44')你一定注意到了。这个撇号表示 hardened(强化)派生,索引要加上 2^31。两者的区别在生娃时用什么”材料”:
- hardened:data 用父私钥参与。相当于这间房上了锁,没有户主的钥匙(私钥)就生不出孩子。更安全,但外人帮不上忙;
- 普通:data 用父公钥参与。好处是”只读钱包”可以完全不碰私钥,就从账户口派生出所有子地址来监听余额——只看账本不动钱;风险是,如果某个子私钥连同父公钥、chain code 一起泄漏,攻击者能反推出父私钥,全家私钥团灭。
所以 BIP44 的设计是:purpose、coin type、account 这几级全部用 hardened,把不同账户硬隔离(各家锁各家的门);change 和 address_index 两级用普通派生,方便观察钱包。安全与便利,各取所需。
m/44’/60’/0’/0/0:从省到门牌号
这串看起来像乱码的路径,就是最常见的”以太坊第一个账户”的派生路径。别怕,它就是一个逐级定位的过程,跟收快递填地址一个道理:先定省,再定市,再定区,最后才是街道门牌号。
| 段 | 含义 | 类比 |
|---|---|---|
m |
主密钥(master),由种子直接生成 | 户主本人 |
44' |
purpose,固定为 44,表示”我遵循 BIP44 标准” | 行政区划国标,大家按同一套规则填地址 |
60' |
coin type,币种编号,60 是以太坊在 SLIP-44 注册表里的编号 | 省 |
0' |
account,账户序号,第 0 个账户(hardened,账户之间互相隔离) | 市 |
0 |
change,0 = 外部链(收款地址),1 = 找零链 | 区 |
0 |
address_index,该链条下的第 0 个地址 | 街道门牌号 |
还是觉得绕?直接看树长什么样:
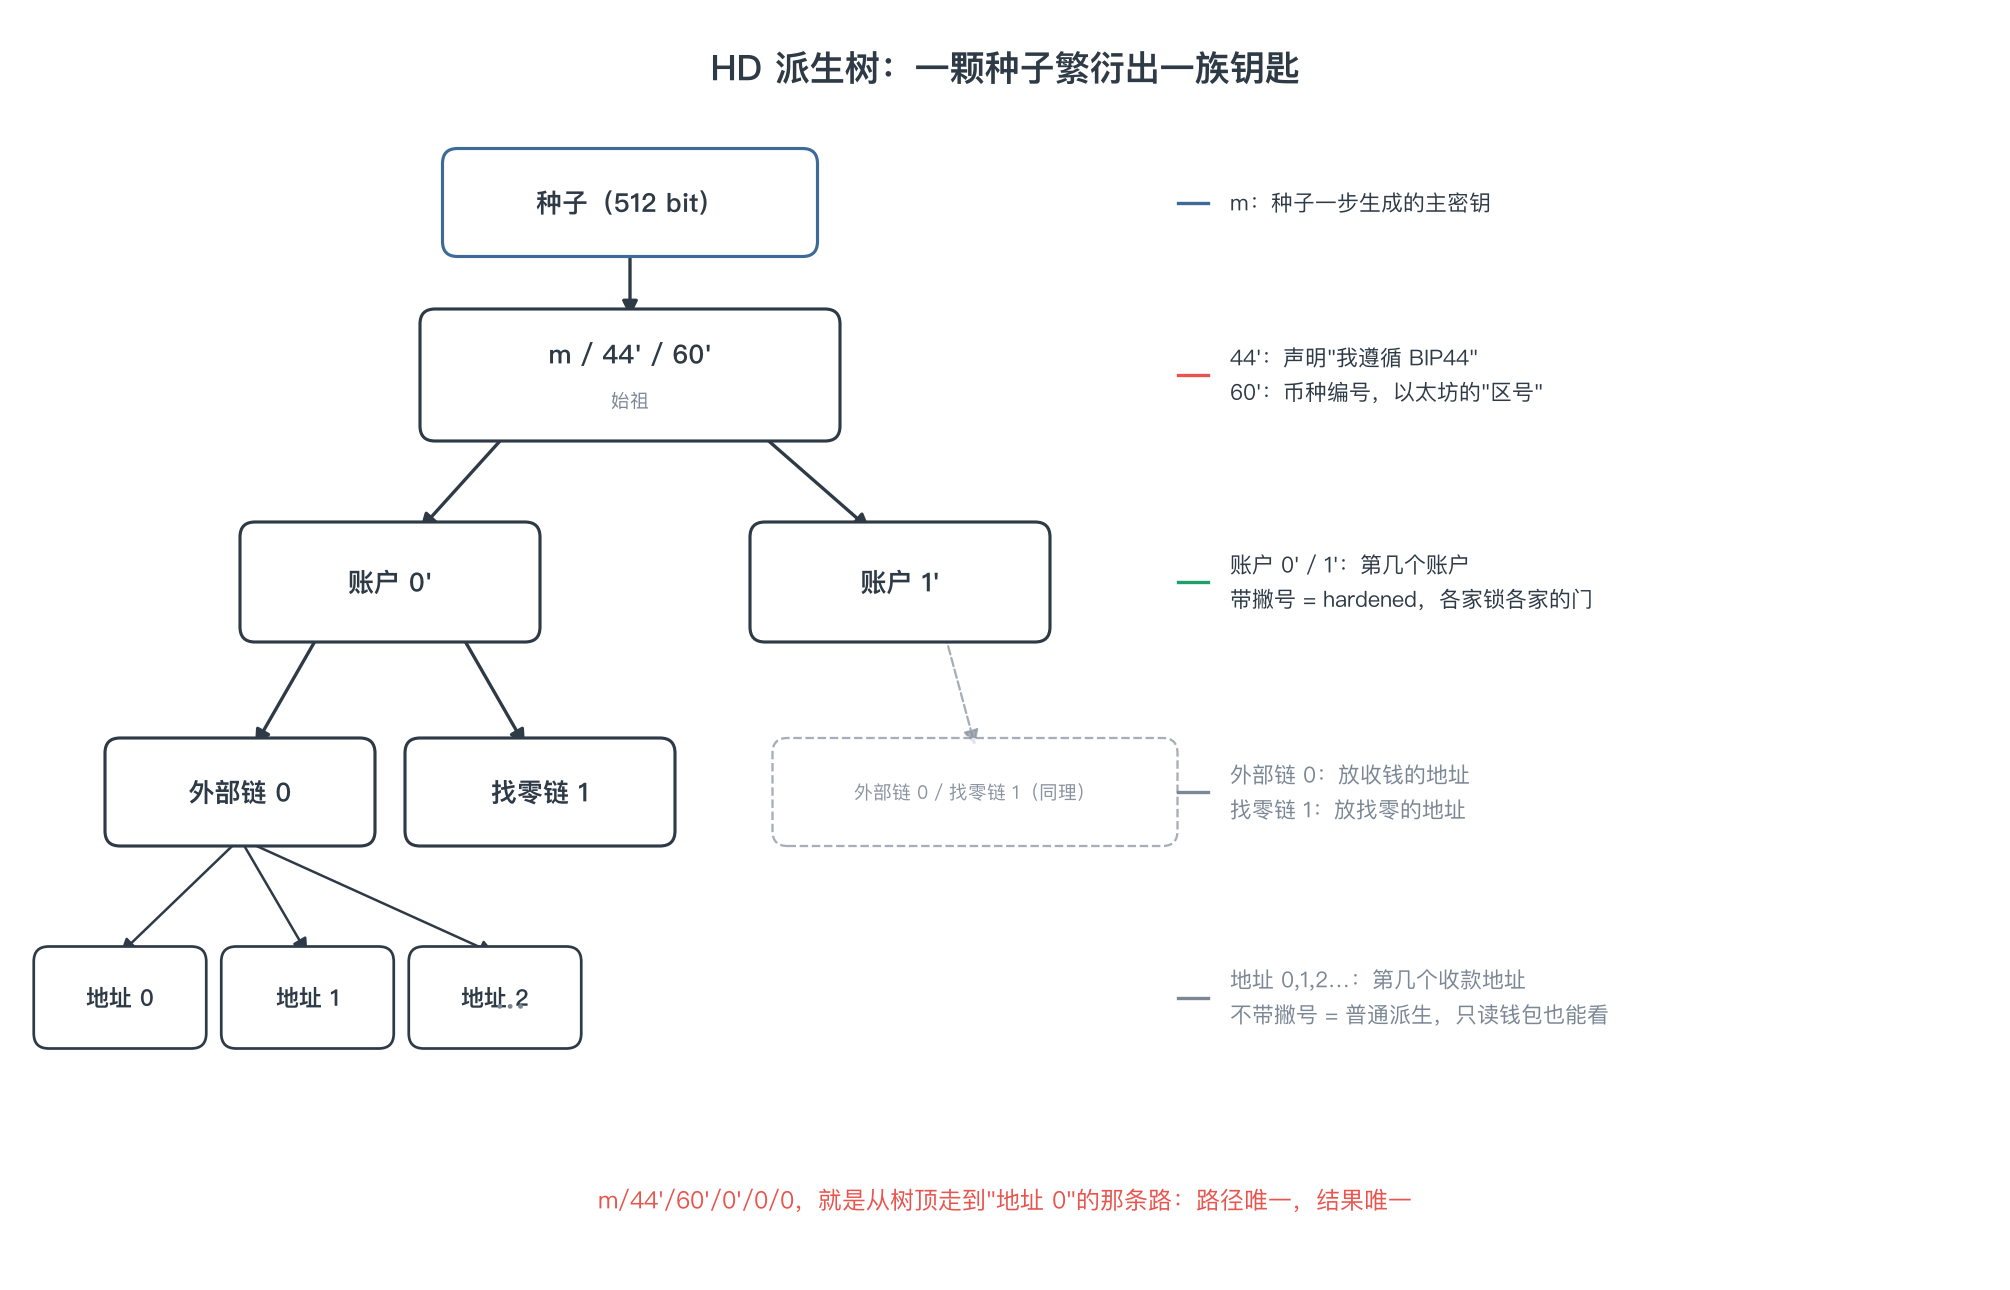
想开第二个账户?把 account 从 0 改成 1(m/44'/60'/1'/0/0)。想要第二个收款地址?把最后的门牌号 0 改成 1,以此类推。前四级不动,只换门牌。
要说明的是:真实的 BIP32 实现里,普通派生时子公钥还需要一步椭圆曲线点加法(
子公钥 = 父公钥 + IL×G)才能和子私钥对应上。本文的演示只跑 HMAC-SHA512 链和私钥层面的模加,展示的是派生的结构,省略了椭圆曲线那一步,特此诚实标注。
地址:公钥的”摘要”
到了解开旧文伏笔的时刻。旧文里我把公钥直接当地址用(偷懒了),真实的以太坊地址是这样算的:
1 | Keccak-256(非压缩公钥去掉 04 前缀的 64 字节) 的最后 20 字节 |
也就是对 X || Y 那 64 字节做 Keccak-256 哈希,丢掉前 12 字节,剩下 20 字节(40 个 hex 字符)就是地址。一个 256 位的公钥,被”摘要”成了一个 160 位的地址。
为什么叫”摘要”?跟论文摘要一个道理:全文(公钥)太长,平时递名片用摘要(地址)就够了。但从摘要还原不出全文——哈希是单向的,谁也没法从地址反推出公钥,更别说私钥了。
彩蛋:这里的 Keccak-256 和 NIST 标准的 SHA3-256 不是同一个函数。Keccak 赢得了 SHA3 竞赛之后,NIST 把填充规则改了才发布为 SHA3。以太坊选在改动之前就用上了原始版 Keccak,所以
keccak256(m) != sha3_256(m)。用标准库的 SHA3 算地址,会算出一个”没人拥有”的地址,这是历史遗留的经典坑。
EIP-55:给地址装个”验证码”
以太坊地址不区分大小写——0xabc 和 0xABC 是同一个地址。这带来一个问题:转账时抄错一个字母,没人拦你,钱就飞了。
EIP-55 的方案很巧妙:对地址的小写形式再算一次 Keccak-256,用哈希结果的每个 nibble(4 bit)决定对应位置字母的大小写(nibble ≥ 8 就大写)。数字不受影响,字母的大小写里则藏了一层校验信息——这就是地址自带的”验证码”,跟快递单号最后那位防错校验位是一个思路。抄错一个字母,钱包校验不过,直接报警拒转。这个机制在下面动手环节会真实演示。
比特币那边:零钱钱包 vs 银行账户
比特币的地址体系是另一套画风:早期地址用 Base58Check 编码(特意去掉了 0OIl 这些容易看混的字符——连编码都在防手滑),SegWit 之后用 Bech32(bc1 开头),编码细节本文一句带过,感兴趣可以自行展开。
更值得对照的是记账方式,两边简直是两种人:
- 比特币:UTXO 模型(Unspent Transaction Output)。账本里压根没有”余额”这个字段,只有一堆没被花掉的输出。你的钱包就像一个装现金的零钱钱包:里面躺着几张固定面额的”钞票”(UTXO),所谓余额,就是所有钞票面额的总和。花 1 个 BTC,实际是掏出一张整钞烧掉,重新印两张新的:一张给对方,一张找零给自己。现金付账,找零的本质是”烧旧票、印新票”。
- 以太坊:账户模型。每个地址就是一个账户对象,自带余额字段。转账就是把 A 的余额减一点、B 的加一点,跟银行账户一模一样。
还记得 《从零开始构建区块链》 里那个 balances 字典吗?那就是账户模型。所以旧文玩具链的交互逻辑更像以太坊,不是巧合,是因为账户模型写起教学代码来简单——UTXO 光是找零逻辑就能多写两百行。
同一套助记词,为什么能管多条链
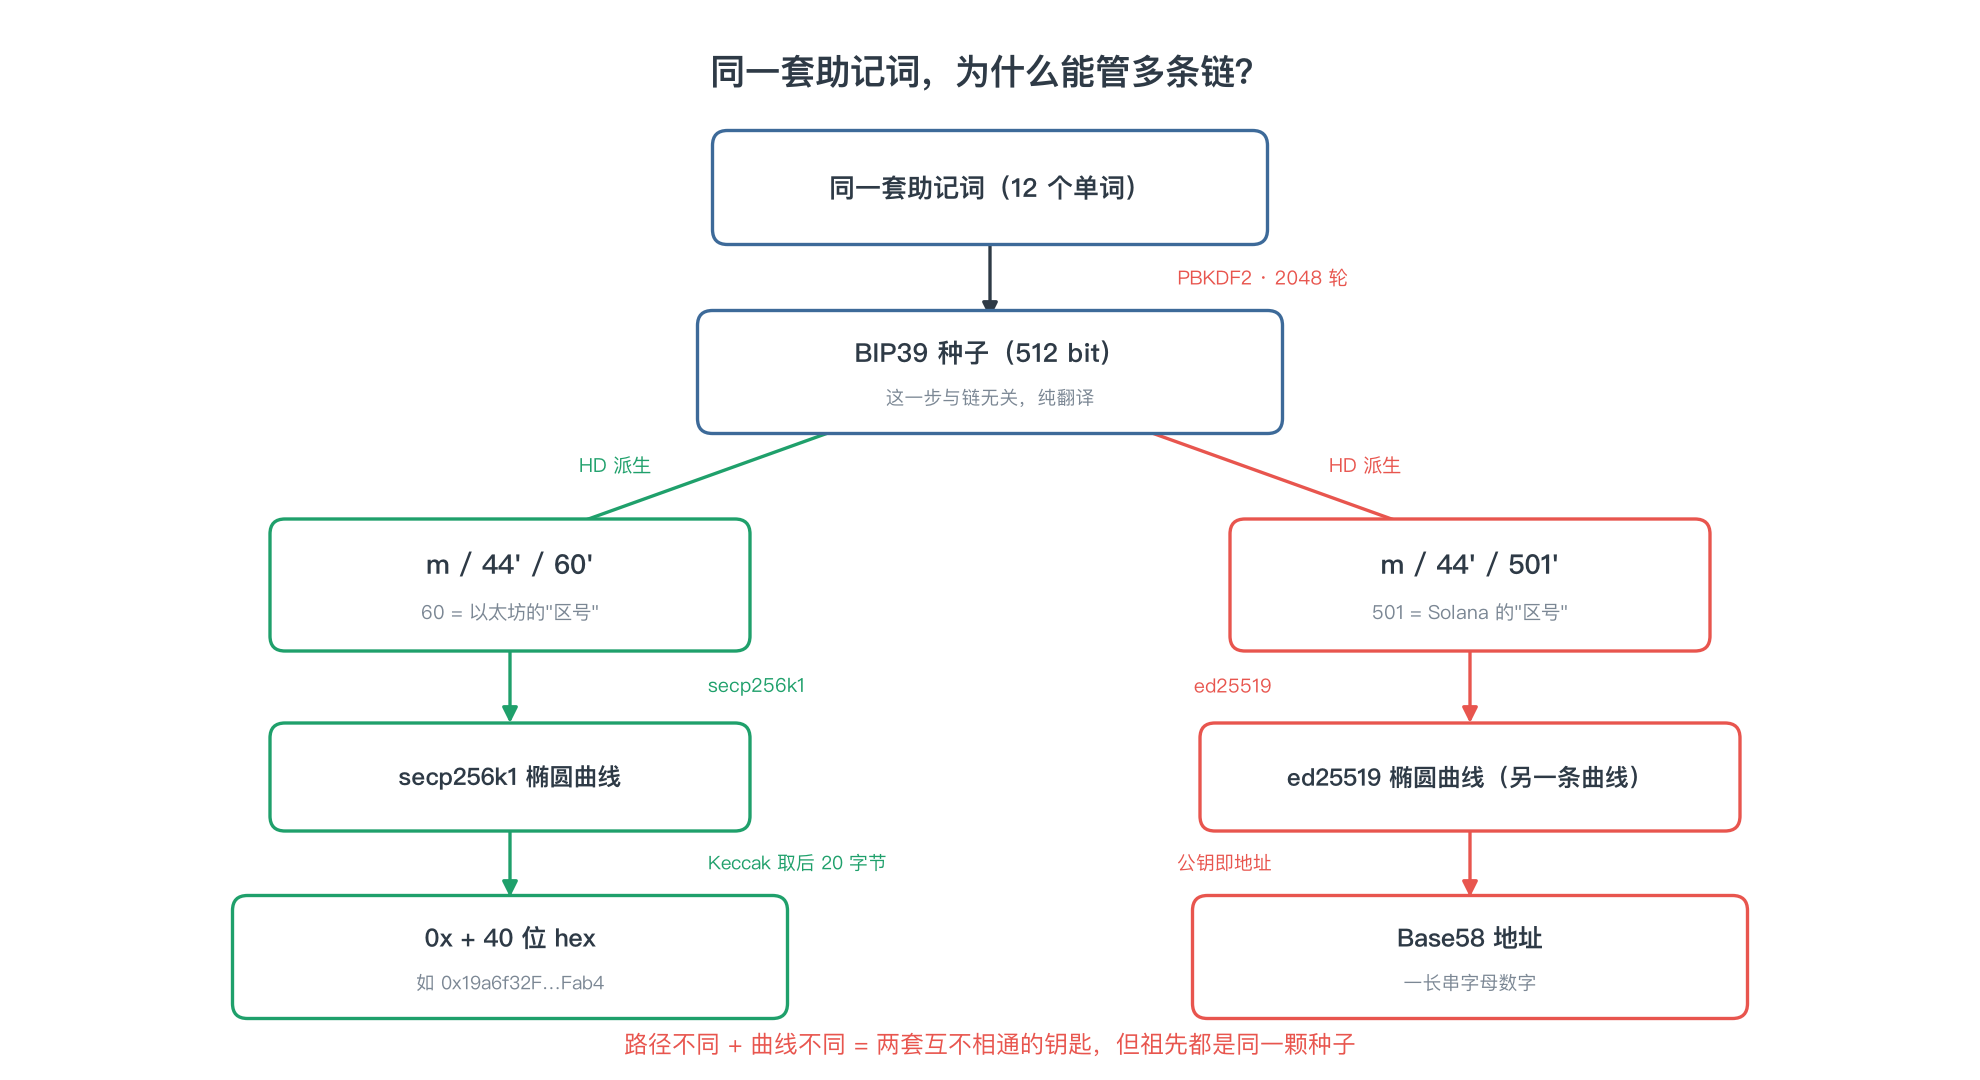
现在把前面的知识串起来,谜底就揭开了:
- BIP39 让助记词变成唯一的种子——这一步和链无关,纯粹是”人话变字节”;
- BIP32 让种子长成一棵无限的密钥树——这一步也和链无关;
- BIP44 给每条链在树上分了一个”区号”(coin type)——以太坊是 60,比特币是 0,Solana 是 501。
所以”多链钱包”的本质就是:同一棵家谱树上,每条链认领自己的分叉。 就像同一个家族,老大落户北京(60 号分舵),老二落户上海(501 号分舵),但户口本还是同一本。EVM 系的链(Base、BNB Chain、Polygon……)干脆共用 m/44'/60',因为它们本来就是一个生态,地址格式都一样。
有一点要诚实说明:Solana 用的是 ed25519 曲线(不是 secp256k1),派生算法的细节也有差异(ed25519 的 hardened 派生实现各有讲究),所以严格说是”同一个种子沿不同路径/曲线派生出不同链的钥匙”,而不是简单地换个 coin type 就完事。这也是旧文”多链支持”一节里 SolanaWallet 要单独实现的原因——接口要适配,曲线和派生也得适配。
动手模拟:从熵到地址的完整之旅
上面这张多链分叉图就是终点风景,我们先回到起点,把整条流水线亲自走一遍。全程路线如下:
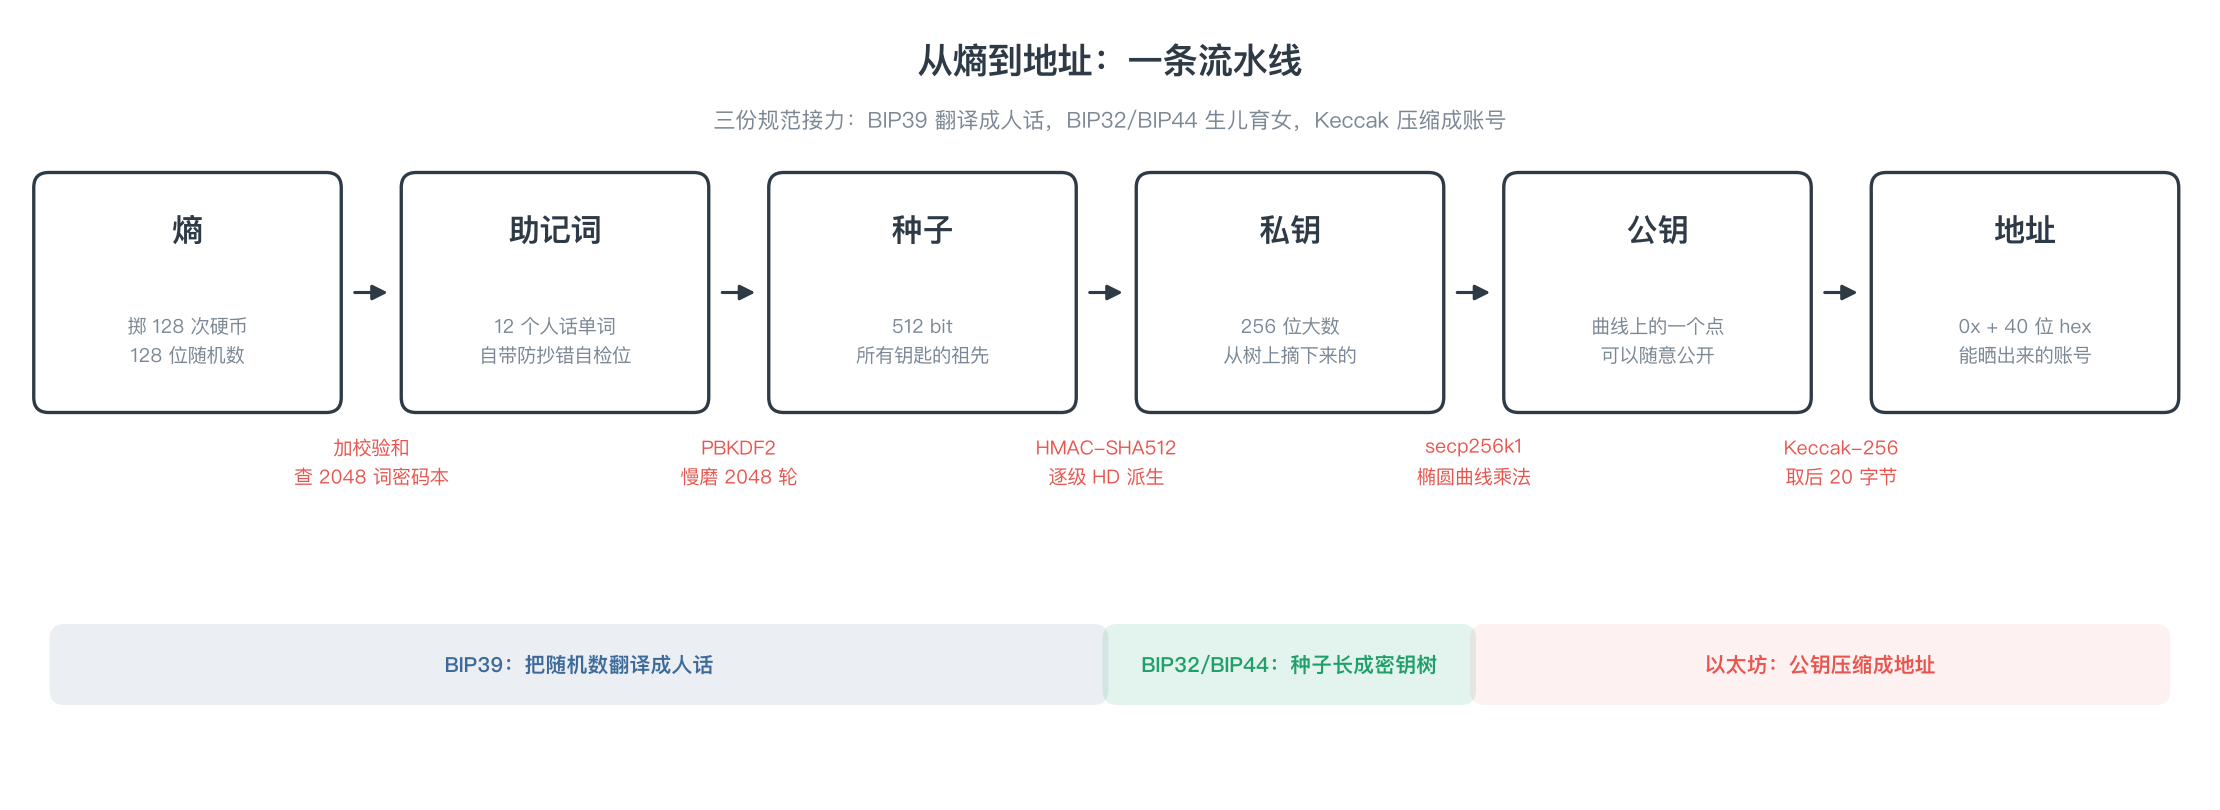
下面把整条链路用 Python 跑一遍。三段代码是真实串联的:第一段磨出的种子喂给第二段,第二段摘出的私钥喂给第三段。依赖安装:pip install ecdsa eth-account(第二段只用标准库)。
第一步:掷骰子 → 助记词 → 种子
先看代码。再次强调:16 词 mini 词表是教学简化,真实 BIP39 是 2048 词 × 11 bit。另外这次运气不错,跑出来的助记词正好是词表前三个词,属于”BIP39 学区房”了:
1 | import hashlib |
真实运行输出(熵是随机的,你跑出来的值会不同,流程一致):
1 | 熵(8 bit): 70 |
重点看输出最后四行:
- 抄错一个词,校验立刻
False——这就是”自检位”在兜底,真实钱包会直接拒绝你导入,而不是默默给你恢复一个空钱包; - 同样的助记词,加个 passphrase
lucifer,种子立马面目全非——这就是”第 25 个词”的作用:卡还在,密码换了,门就刷不开了。
第二步:种子 → m/44’/60’/0’/0/0
拿着上一步磨出的种子,沿标准路径逐级”生娃”。简化点前文已标注:普通派生时真实实现用的是父公钥(并涉及椭圆曲线运算),这里统一用父私钥演示结构:
1 | import hashlib |
真实运行输出:
1 | m 私钥: bead5d1f4dc7aae04363a25201d3a64605281d20e967ba3c5a233ee7d9ff412e |
看输出有个很有意思的现象:每走一级,chain code 都换了一个——父子各有各的”基因”,这就是”分层”的骨架。最后一行 4e97676d...,就是我们这套助记词在以太坊上的第一个账户私钥(按简化演示口径)。
第三步:私钥 → 公钥 → 地址
最后把旧文欠的真实推导补上(依赖 pip install ecdsa eth-account),并且用官方库交叉验证我们手推的结果:
1 | import eth_utils |
真实运行输出:
1 | 公钥(64 字节) : 5b43ded3eb938c342df50a59688f9145e4b761ee1fe1f21b2d94298be9683c0dd0890d030e00b687527eb55a02d283d95ec1f13879d78cb2577340a29ed55438 |
自己手推的 EIP-55 地址和官方库算出来的一模一样,这感觉比期末考试对答案还爽。注意看地址里混着的大写字母——那就是 EIP-55 藏进去的”验证码”。你现在也可以去旧文提到的 bip39 网站 输入自己的助记词对照各条链的派生路径,亲眼看看 60 和 501 是怎么分家的。
总结
最后把整条流水线再串一遍(对着动手环节开头那张图看更清楚):
- 熵(128 bit 随机数,掷骰子)经过 SHA256 自检位、查 2048 词密码本,变成助记词(BIP39,2048 词 × 11 bit,本文演示用了 16 词 mini 词表);
- 助记词经过 PBKDF2(慢磨 2048 轮,盐是
mnemonic + passphrase)变成 512 位种子; - 种子用 HMAC-SHA512 生成主密钥和主 chain code,然后沿
m/purpose'/coin_type'/account'/change/address_index这棵家谱树逐级 HD 派生(BIP32 定义算法,BIP44 定义路径语义),hardened 把各家锁上门,普通派生留给只读钱包; - 私钥经椭圆曲线乘法(公共模具 G)压出公钥(secp256k1,正向秒算,反向无解);
- 公钥经 Keccak-256 取后 20 字节得地址,EIP-55 再给它藏一层大小写”验证码”。
至此你也应该明白了:钱包软件从来没有”保存”过你的任何一个地址的私钥,它保存的只是那 12/24 个词,其余的一切都是每次需要时现场算出来的。同一套助记词管多链,不过是同一棵树上的不同分叉而已。
当然,这也是把双刃剑:家谱树好用,但树根一漏,全族团灭。想分散风险,可以看单私钥的另一条出路——把密钥拆成多个分片保存(MPC 钱包);想知道私钥和地址在 DeFi 里怎么被人拿去授权花你的钱,可以看授权与撤销授权那篇。链接都在下面。
本文所有代码都在 Python 3.11 下真实运行过,完整脚本如有需要可以留言。下一篇(如果有的话)打算讲讲交易签名与验证的细节——私钥拿到了,怎么给一笔交易签字,签出来的东西链上怎么验。欢迎留言催更,虽然上次留言也不多。
相关阅读
- 《Web3 的入口 - 区块链钱包》:本文的直接前置,钱包与 Dapp 的交互在那篇
- 《更加安全的区块链钱包:MPC 钱包》:单私钥的另一条出路——密钥拆分
- 《Web3 中的授权与撤销授权》:私钥怎么签名交易、地址在授权里的角色
- 《从零开始构建区块链》:旧文里公钥直当地址的教学简化,本文补上真实推导
感谢大家的阅读,希望本文对大家有所帮助。